Словник термінів штучного інтелекту: 55 понять простими словами (2026)
Усі терміни, які трапляються у світі ШІ, — від токенів і промптів до великих мовних моделей, галюцинацій, RAG і ШІ-агентів — простими словами та з прикладами, у шести розділах: від основ до безпеки й законів.
Для кого цей словник? Для всіх, хто зустрічає в розмовах, новинах чи ШІ-сервісах слова на кшталт «токен», «промпт» чи «велика мовна модель» і хоче зрозуміти їх без технічної підготовки. Для кожного терміна наведено англійський оригінал, просте визначення й за потреби приклад.
Якщо ви тільки знайомитеся з ШІ, почніть із посібника «Що таке штучний інтелект і як він працює?», а цю сторінку збережіть як довідник.
Як користуватися словником
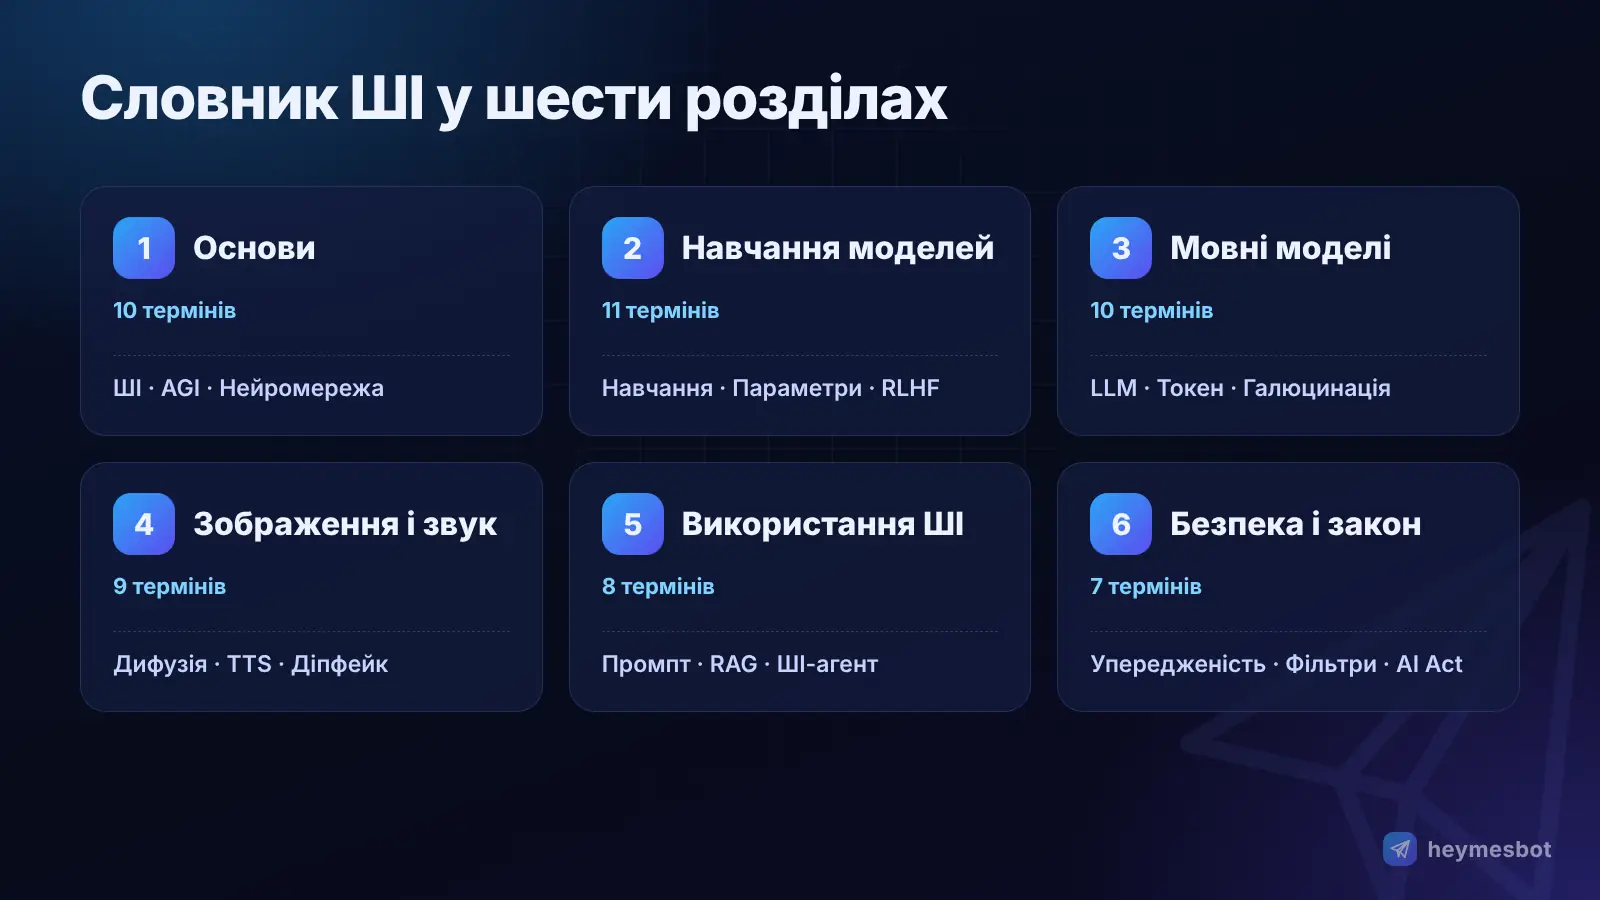
Терміни поділено на шість розділів — від основ до безпеки й законів
Поруч із кожним терміном зазначено англійський варіант, щоб упізнавати його в інших джерелах
Для швидкого пошуку скористайтеся пошуком на сторінці (Ctrl+F)
1. Основи
Штучний інтелект (Artificial Intelligence, AI)
Програма, яка вивчає закономірності на даних, а не виконує заздалегідь прописані правила, і використовує їх для розуміння мови, розпізнавання зображень чи створення контенту. Так само називається й уся ця галузь.
Вузький ШІ (Narrow AI)
ШІ, який добре виконує одне чи кілька завдань: переклад, розпізнавання облич, діалог. Усі сучасні ШІ-інструменти, навіть найпросунутіші чат-боти, належать до вузького ШІ.
Загальний штучний інтелект (Artificial General Intelligence, AGI)
Гіпотетичний ШІ, здатний опанувати й виконати майже будь-яке інтелектуальне завдання людини в будь-якій галузі. AGI — дослідницька мета багатьох лабораторій, але його поки немає, і єдиної думки щодо строків не існує.
Надінтелект (Artificial Superintelligence, ASI)
Гіпотетичний ШІ, що перевершує найрозумніших людей майже в усьому. Обговорюється переважно в контексті майбутнього й безпеки ШІ.
Алгоритм (Algorithm)
Точна послідовність кроків для розв'язання задачі. У ШІ алгоритми визначають, як відбувається навчання, а його результатом стає «модель».
Модель (Model)
Результат навчання ШІ-системи: файл із мільйонів чи мільярдів чисел, у яких стиснуто її знання. Коли кажуть «вийшла нова модель», мають на увазі саме цей навчений файл.
Машинне навчання (Machine Learning, ML)
Розділ ШІ, у якому машина навчається на прикладах, а не програмується явно. Спам-фільтри пошти й рекомендації в стримінгових сервісах — щоденні приклади.
Глибоке навчання (Deep Learning)
Вид машинного навчання на нейромережах із великою кількістю шарів. Найбільші прориви останнього десятиліття — від розпізнавання мовлення до чат-ботів — прийшли з глибокого навчання.
Нейронна мережа (Neural Network)
Структура, натхненна мозком, що складається з шарів штучних «нейронів». Кожен нейрон комбінує числа з різними вагами й передає результат далі. Нобелівську премію з фізики 2024 року отримали піонери цієї ідеї.
Генеративний ШІ (Generative AI)
Моделі, що створюють новий контент: текст, зображення, відео, звук чи код. ChatGPT, генератори картинок і музики — приклади генеративного ШІ.
2. Як навчаються моделі
Навчальні дані (Training Data)
Приклади, на яких навчається модель: тексти, зображення, аудіо. Якість і різноманітність даних безпосередньо впливають на точність і упередженість моделі.
Навчання (Training)
Процес, у якому модель знову й знову робить припущення, його порівнюють із правильною відповіддю й трохи коригують параметри. Навчання великих моделей триває тижні чи місяці на тисячах процесорів.
Попереднє навчання (Pre-training)
Перший етап навчання великих моделей: модель бачить величезний обсяг загальних даних і засвоює загальні закономірності, перш ніж її налаштують під конкретне завдання.
Параметри, або ваги (Parameters / Weights)
Числа всередині моделі, які налаштовуються під час навчання й зберігають вивчене. Великі мовні моделі мають мільярди параметрів, але більше параметрів не завжди означає кращу модель.
Навчання з учителем (Supervised Learning)
Навчання на прикладах із відомими правильними відповідями, наприклад на тисячах фото з підписами «кіт» чи «собака». Модель учиться переходити від вхідних даних до правильної відповіді.
Навчання без учителя (Unsupervised Learning)
Навчання на нерозмічених даних для пошуку закономірностей чи груп, наприклад автоматичне групування клієнтів за поведінкою під час покупок.
Навчання з підкріпленням (Reinforcement Learning)
Метод, за якого модель учиться методом спроб і помилок, отримуючи «винагороди» чи «штрафи». Саме так AlphaGo перемогла чемпіона світу з го.
Навчання з підкріпленням на відгуках людей (RLHF)
Етап навчання чат-ботів, коли люди ранжують різні відповіді моделі, і вона вчиться давати корисніші, чесніші й безпечніші.
Донавчання (Fine-tuning)
Додаткове навчання вже навченої моделі на спеціалізованіших даних, щоб вона краще виконувала конкретне завдання чи працювала в певній галузі, наприклад із юридичними текстами.
Перенавчання (Overfitting)
Ситуація, коли модель запам'ятовує навчальні приклади замість загальної закономірності: на них вона блискуча, а на нових даних слабка. Як студент, що визубрив відповіді, але не зрозумів предмет.
Інференс (Inference)
Етап використання навченої моделі: вона отримує нові дані й видає відповідь. Щоразу, коли ви спілкуєтеся з чат-ботом, модель виконує інференс і не вчиться у вас.
3. Мовні моделі та чат-боти
Велика мовна модель (Large Language Model, LLM)
Дуже велика нейромережа, навчена на величезних обсягах тексту передбачати наступне слово. Ця проста здатність лежить в основі написання, переказу, перекладу й діалогів чат-ботів.
Трансформер (Transformer)
Архітектура нейромережі, представлена у статті Attention Is All You Need 2017 року, що лежить в основі майже всіх великих мовних моделей. Літера «T» у GPT — це й є Transformer.
Механізм уваги (Attention)
Частина трансформера, що дає змогу моделі для кожного слова зрозуміти, які інші слова тексту найважливіші, наприклад, до якого іменника належить «він».
Токен (Token)
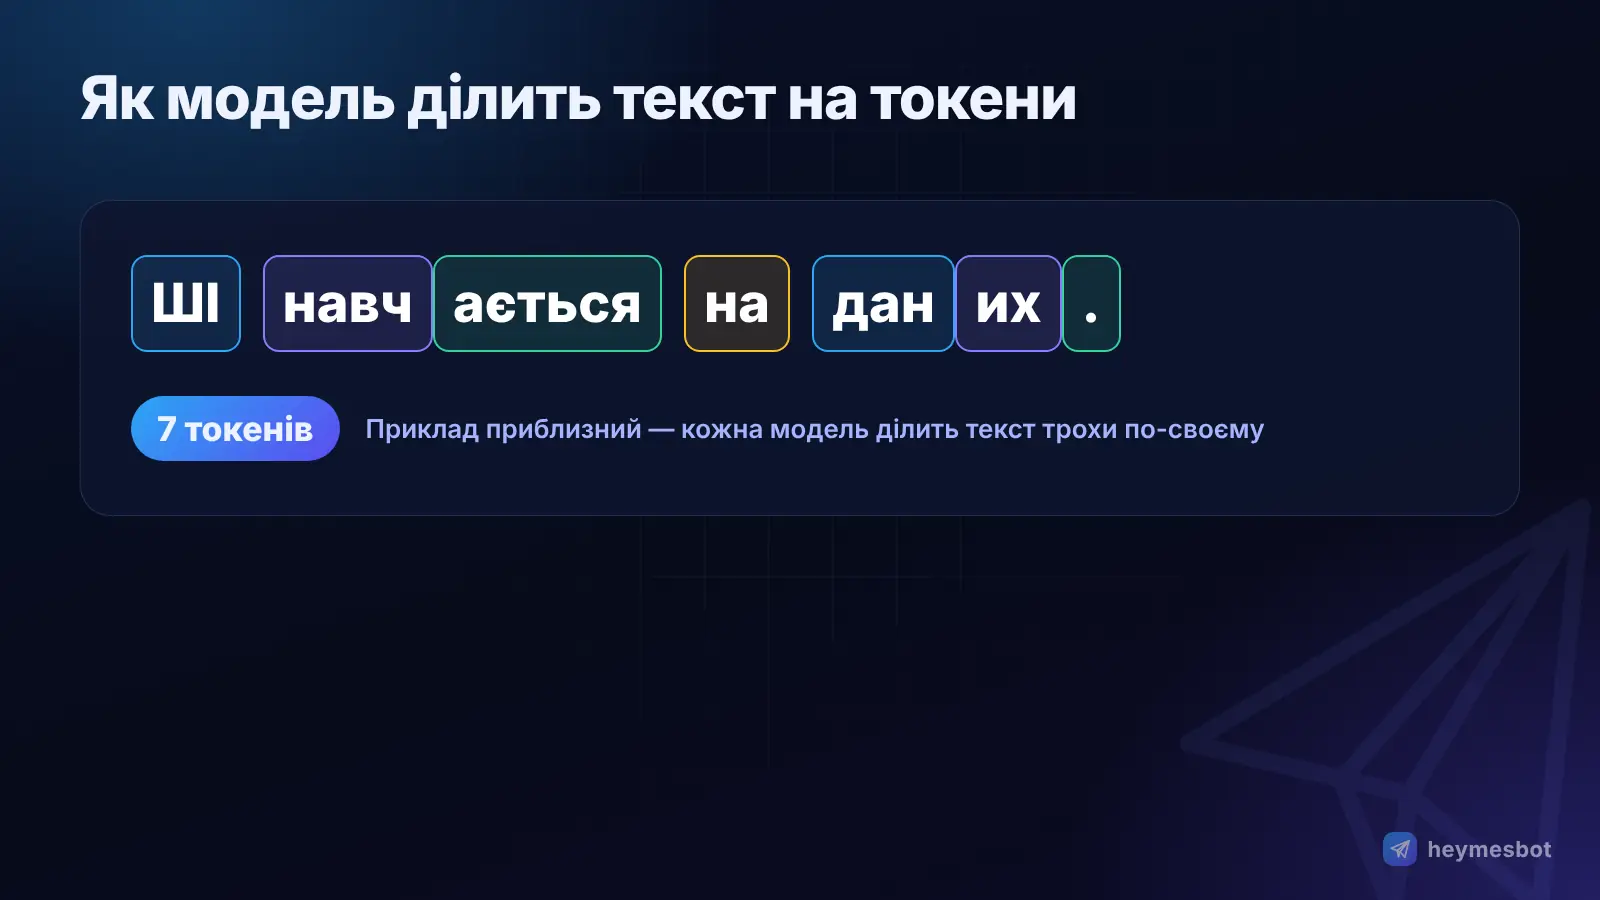
Найменший фрагмент тексту, з яким працює модель: слово, частина слова чи знак. В англійській один токен — приблизно три чверті слова, в українській слово часто ділиться на кілька токенів. Вартість використання й обмеження довжини вимірюються в токенах.
Контекстне вікно (Context Window)
Максимальний обсяг тексту в токенах, який модель «бачить» одночасно, включно з попередніми повідомленнями й прикріпленими документами. Якщо діалог стає довшим, найстаріші частини випадають із робочої пам'яті моделі.
Ембединг (Embedding)
Спосіб перетворити слово, фразу чи зображення на набір чисел так, щоб близькі за змістом речі отримували близькі числа. На ембедингах ґрунтуються семантичний пошук і RAG.
Температура (Temperature)
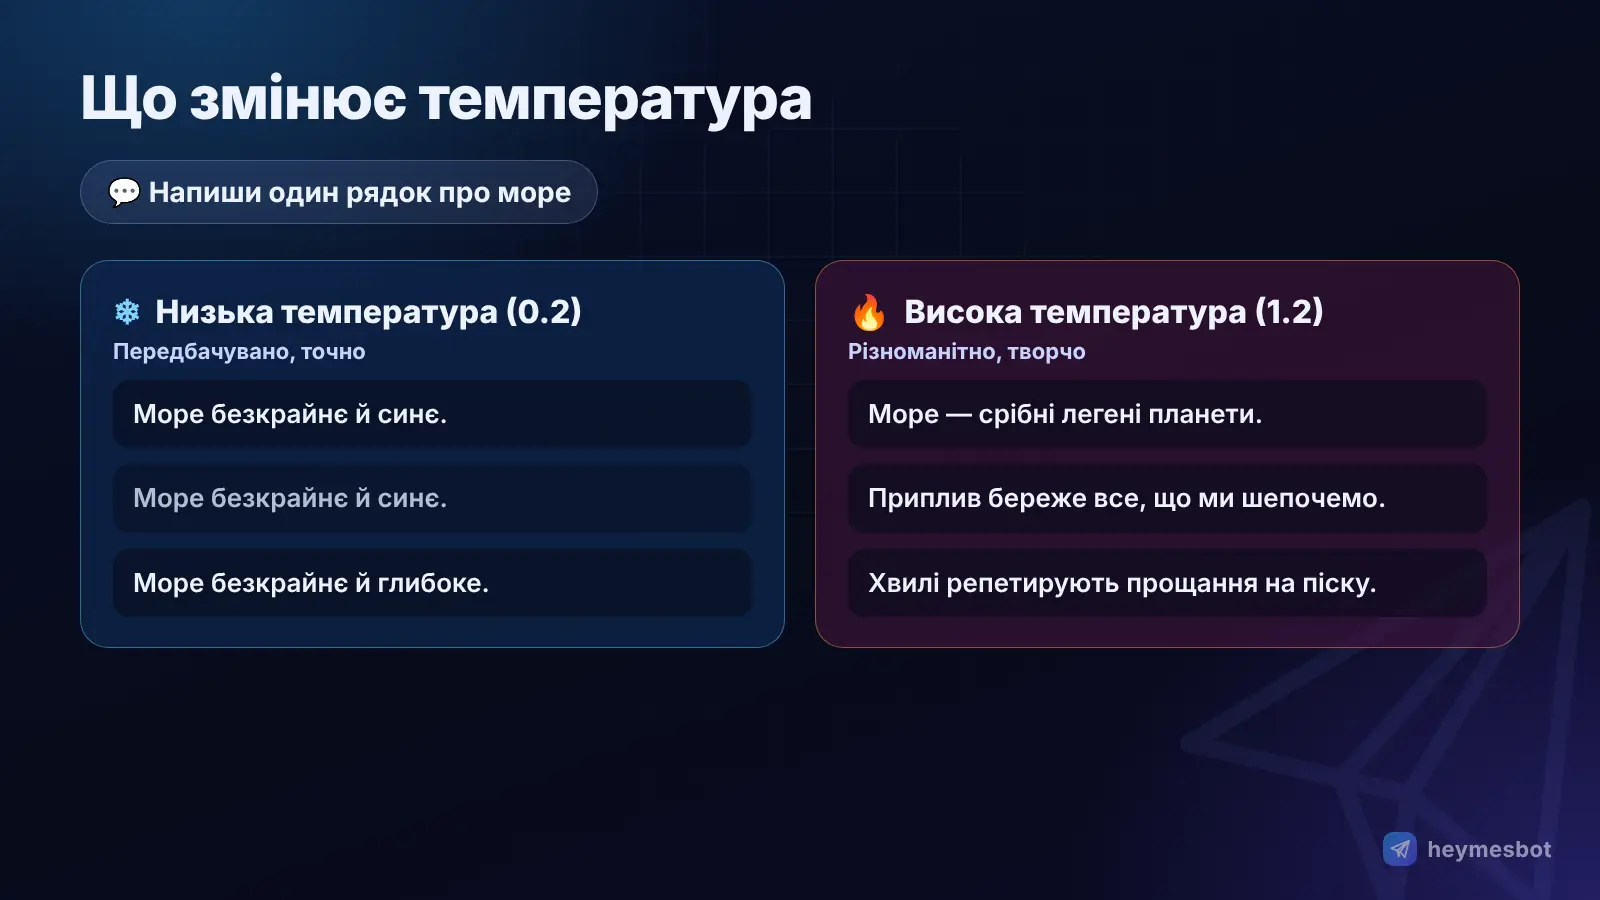
Налаштування, що визначає ступінь випадковості відповідей. Низька температура дає передбачуваніші й точніші відповіді, висока — різноманітніші й творчіші.
Галюцинація (Hallucination)
Гладка й переконлива, але хибна чи вигадана відповідь моделі, наприклад неіснуюча статистика чи фейкове джерело. Виникає тому, що модель навчено видавати правдоподібний текст, а не перевіряти факти.
Чат-бот (Chatbot)
Програма, яка спілкується з користувачем природною мовою. Сучасні чат-боти зазвичай побудовано на великих мовних моделях.
Модель міркувань (Reasoning Model)
Мовна модель, яка перед фінальною відповіддю розбирає задачу крок за кроком. Такі моделі сильніші в математиці, програмуванні й багатокрокових задачах, але зазвичай повільніші й дорожчі.
4. Зображення, відео та звук
Дифузійна модель (Diffusion Model)
Основний метод більшості сучасних генераторів зображень. Модель навчилася крок за кроком прибирати шум із картинки; під час генерації вона починає з чистого випадкового шуму й, керуючись вашим текстом, перетворює його на зображення.
Текст у зображення (Text-to-Image)
Створення картинки за текстовим описом, наприклад «маяк на заході сонця, акварель».
Редагування зображень із ШІ (Inpainting)
Зміна частини наявного зображення за текстовою командою: видалити об'єкт, замінити фон чи додати деталь, не чіпаючи решти.
Текст у відео (Text-to-Video)
Створення короткого відео за описом чи зображенням. Оскільки кадри мають лишатися узгодженими в часі, генерація відео коштує значно дорожче за картинку.
Синтез мовлення (Text-to-Speech, TTS)
Перетворення тексту на природне мовлення з відповідною інтонацією та паузами. Застосовується в аудіокнигах, озвученні відео й голосових асистентах.
Розпізнавання мовлення (Speech-to-Text, ASR)
Перетворення усного мовлення на текст, наприклад автоматичні субтитри чи голосове введення.
Клонування голосу (Voice Cloning)
Створення за допомогою ШІ голосу, схожого на голос конкретної людини. Через ризик зловживань і права власника голосу більшість надійних сервісів обмежують імітацію голосів реальних людей без дозволу.
Діпфейк (Deepfake)
Підроблене, але реалістичне фото, аудіо чи відео, створене ШІ, де людина говорить чи робить те, чого ніколи не робила. Не довіряйте шокуючому контенту без надійного джерела.
Мультимодальність (Multimodal)
Здатність моделі розуміти чи створювати одразу кілька видів даних, наприклад дивитися на фото й обговорювати його або створювати зображення та звук із тексту.
5. Використання ШІ
Промпт (Prompt)
Текст чи інструкція, яку ви даєте ШІ: питання, прохання чи опис зображення. Від якості промпту безпосередньо залежить якість результату.
Промпт-інжиніринг (Prompt Engineering)
Навичка складання промптів для найкращого результату: вказати роль, мету, аудиторію, формат відповіді й дати приклади.
Системний промпт (System Prompt)
Прихована інструкція, яку творець чат-бота передає моделі на початку кожного діалогу, задаючи її поведінку, тон і обмеження.
Zero-shot і few-shot
У режимі zero-shot ви просто формулюєте запит; у режимі few-shot додаєте кілька прикладів потрібного входу й виходу, щоб модель вловила шаблон. Кілька хороших прикладів часто різко покращують результат.
Генерація з доповненням пошуком (Retrieval-Augmented Generation, RAG)
Метод, за якого модель спершу знаходить потрібні відомості в зовнішньому джерелі, наприклад у документах компанії чи вебпошуку, і будує відповідь на їхній основі. Це робить відповіді актуальнішими й зменшує галюцинації.
ШІ-агент (AI Agent)
Система, яка не просто відповідає, а сама планує й виконує кілька кроків заради мети: шукає, користується інструментами, створює файли й перевіряє результат.
API (програмний інтерфейс)
Спосіб, у який програми безпосередньо підключаються до ШІ-моделі. Багато застосунків і ботів використовують моделі великих компаній через API, зазвичай сплачуючи за кожен токен.
Відкрита модель (Open-source / Open-weight Model)
Модель, параметри якої опубліковано, тож її можна завантажити, запустити на своєму сервері чи донавчити. Закриті моделі доступні лише через сервіс або API розробника.
6. Безпека, етика й закон
Упередженість (Bias)
Схильність моделі до несправедливих чи однобоких результатів, зазвичай через перекоси в навчальних даних, наприклад завжди зображувати певну професію людьми однієї статі.
Узгодження (Alignment)
Зусилля, щоб поведінка ШІ відповідала цілям і цінностям людей: лишалася корисною, чесною й безпечною та робила те, що ми справді маємо на увазі.
Обмежувачі, або фільтри безпеки (Guardrails)
Правила й фільтри, за допомогою яких розробники моделей не дають їм видавати небезпечний, незаконний чи шкідливий контент. Коли сервіс відхиляє запит «через обмеження контенту», зазвичай спрацьовують саме вони.
Джейлбрейк (Jailbreak)
Спроба обдурити модель спеціальними промптами, щоб вона проігнорувала обмеження безпеки. Розробники постійно виявляють і блокують такі прийоми, а їх використання зазвичай порушує правила сервісу.
Водяні знаки й маркування ШІ-контенту (AI Watermarking)
Видимі чи приховані позначки в створеному ШІ контенті, що дають змогу визначити його походження. Нові норми, зокрема Закон ЄС про ШІ, рухаються до того, щоб зробити їх обов'язковими.
Закон ЄС про штучний інтелект (EU AI Act)
Перший у світі комплексний закон про ШІ. Набув чинності 1 серпня 2024 року, а його зобов'язання запроваджуються поетапно. Він поділяє системи за рівнем ризику, забороняє деякі застосування й запроваджує вимоги прозорості для ШІ-контенту.
Конфіденційність даних (Data Privacy)
Захист особистої інформації під час роботи з ШІ. Просте правило: ніколи не вводьте в чат-боти паролі, номери карток, документи й конфіденційні відомості та знайте політику зберігання даних сервісу.
Від термінів до практики
Знати терміни — половина шляху, друга половина — спробувати інструменти. Почніть із чат-сервісу на кшталт ChatGPT, Gemini чи Claude, а якщо зручніше мати чат, створення зображень, відео, озвучення й музику в одному місці просто в Telegram, спробуйте heymesbot. Напишіть кілька простих промптів і подивіться, як «токени», «температура» чи «галюцинації» виглядають на практиці.
Щоб зрозуміти, як ці поняття пов'язані між собою, прочитайте повний посібник «Що таке штучний інтелект і як він працює?»
Коментарі
Коментарів поки немає. Будьте першим.
Залишити коментар
Коментарі з'являються після перевірки. Будь ласка, по темі й ввічливо.