واژهنامه هوش مصنوعی: ۵۵ اصطلاح مهم AI به زبان ساده (۱۴۰۵)
هر اصطلاحی که در دنیای هوش مصنوعی میشنوید، از توکن و پرامپت تا مدل زبانی بزرگ، توهم، RAG و عامل هوش مصنوعی، در این واژهنامه با تعریف ساده و مثال آمده است؛ در شش دسته از مفاهیم پایه تا ایمنی و قانون.
این واژهنامه برای چه کسی است؟ برای هر کسی که در گفتوگو، خبر یا ابزارهای هوش مصنوعی به اصطلاحاتی مثل «توکن»، «پرامپت» یا «مدل زبانی بزرگ» برمیخورد و میخواهد بدون پیشزمینه فنی معنایشان را بفهمد. هر اصطلاح با معادل انگلیسی، تعریف ساده و در صورت نیاز یک مثال آمده است.
اگر تازه با هوش مصنوعی آشنا میشوید، پیشنهاد میکنیم اول راهنمای «هوش مصنوعی چیست و چطور کار میکند؟» را بخوانید و این صفحه را برای مراجعه نگه دارید.
چطور از این واژهنامه استفاده کنید
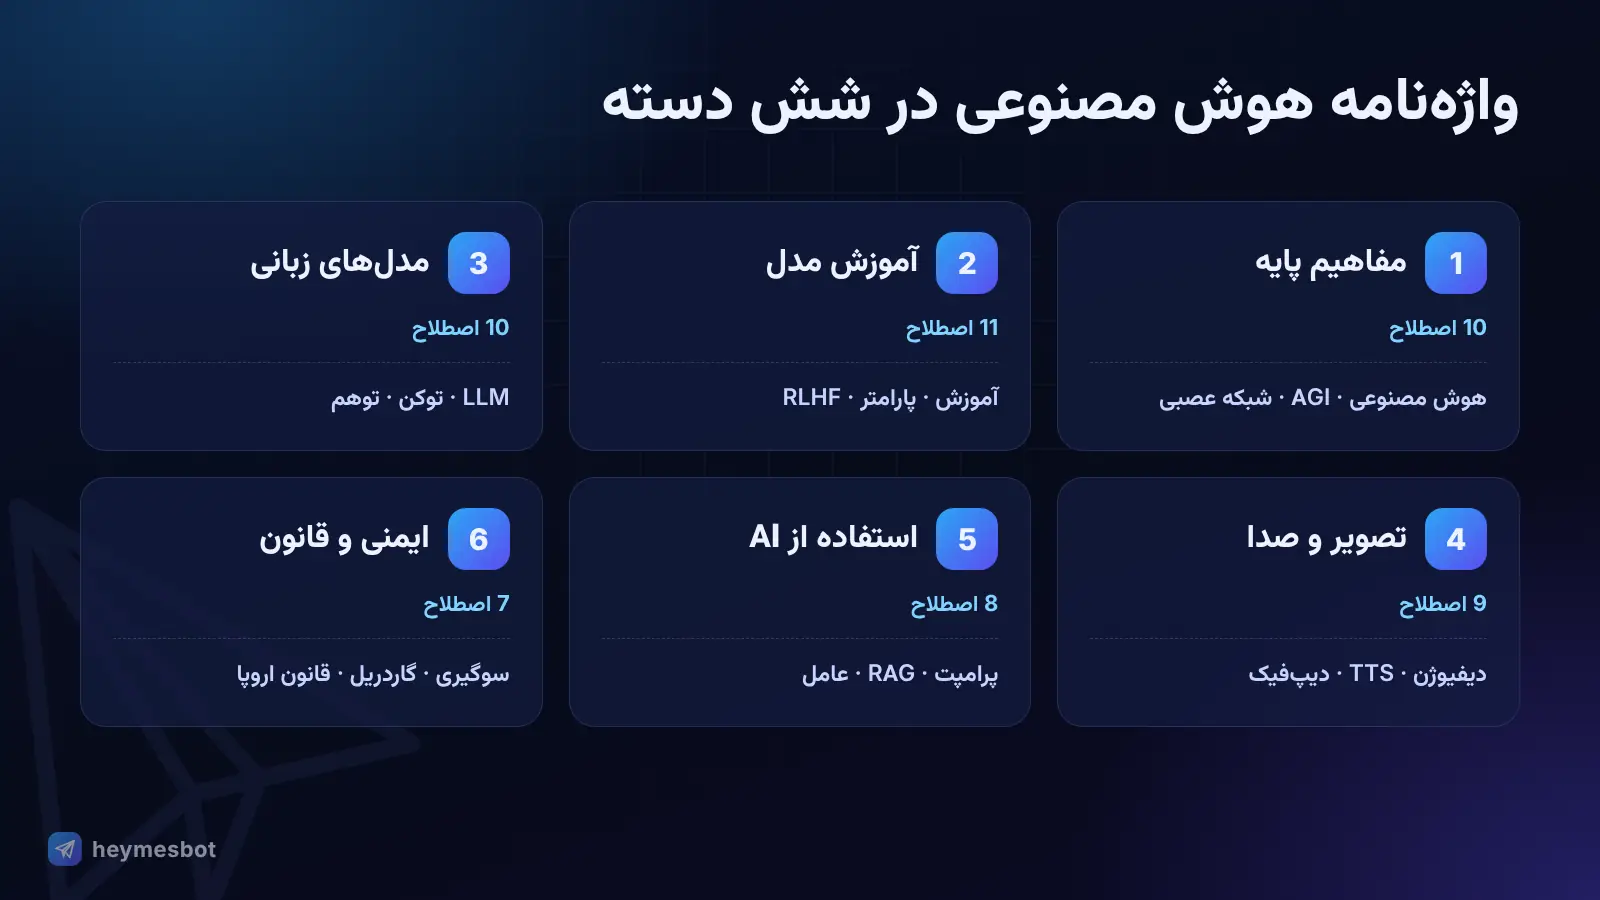
اصطلاحات در شش دسته آمدهاند: از مفاهیم پایه تا ایمنی و قانون
معادل انگلیسی هر اصطلاح کنار آن آمده تا در منابع دیگر هم آن را بشناسید
برای پیدا کردن سریع، از جستجوی مرورگر (Ctrl+F) استفاده کنید
۱. مفاهیم پایه
هوش مصنوعی (Artificial Intelligence, AI)
نرمافزاری که بهجای اجرای قانونهای ازپیشنوشته، الگوها را از داده یاد میگیرد و کارهایی مثل فهم زبان، تشخیص تصویر یا تولید محتوا را انجام میدهد. اسم کل این حوزه هم هست.
هوش مصنوعی محدود (Narrow AI)
هوش مصنوعیای که در یک یا چند کار مشخص خوب است؛ مثل ترجمه، تشخیص چهره یا گفتوگو. همه ابزارهای هوش مصنوعی امروزی، حتی پیشرفتهترین چتباتها، از این نوعاند.
هوش مصنوعی عمومی (Artificial General Intelligence, AGI)
هوش مصنوعی فرضیای که بتواند تقریباً هر کار ذهنی انسان را در هر حوزهای یاد بگیرد و انجام دهد. AGI هدف پژوهشی بسیاری از آزمایشگاههاست، اما هنوز وجود ندارد و درباره زمان رسیدن به آن توافقی نیست.
ابرهوش (Artificial Superintelligence, ASI)
هوش مصنوعی فرضیای که در تقریباً همه زمینهها از باهوشترین انسانها جلوتر باشد. بیشتر در بحثهای آیندهنگرانه و ایمنی مطرح میشود.
الگوریتم (Algorithm)
مجموعهای از مراحل دقیق برای حل یک مسئله. در هوش مصنوعی، الگوریتمها روش یادگیری را تعیین میکنند و نتیجه یادگیری «مدل» است.
مدل (Model)
حاصل آموزش یک سیستم هوش مصنوعی؛ فایلی شامل میلیونها تا میلیاردها عدد که دانستههای مدل در آن فشرده شده است. وقتی میگوییم «یک مدل جدید منتشر شد»، منظور همین فایل آموزشدیده است.
یادگیری ماشین (Machine Learning, ML)
شاخهای از هوش مصنوعی که در آن ماشین بهجای برنامهنویسی صریح، از روی نمونهها یاد میگیرد. فیلتر هرزنامه ایمیل و پیشنهاد فیلم در سرویسهای پخش، مثالهای روزمره یادگیری ماشیناند.
یادگیری عمیق (Deep Learning)
نوعی یادگیری ماشین که از شبکههای عصبی با لایههای زیاد استفاده میکند. پیشرفتهای بزرگ دهه اخیر، از تشخیص گفتار تا چتباتها، حاصل یادگیری عمیق است.
شبکه عصبی (Neural Network)
ساختاری الهامگرفته از مغز که از لایههای «نورون» مصنوعی تشکیل شده است. هر نورون عددهایی را با وزنهای مختلف ترکیب میکند و نتیجه را به لایه بعد میدهد. نوبل فیزیک ۲۰۲۴ به پیشگامان این ایده رسید.
هوش مصنوعی مولد (Generative AI)
مدلهایی که محتوای تازه میسازند: متن، تصویر، ویدیو، صدا یا کد. ChatGPT و ابزارهای ساخت عکس و موسیقی نمونههای هوش مصنوعی مولدند.
۲. مدلها چطور یاد میگیرند
داده آموزشی (Training Data)
نمونههایی که مدل از روی آنها یاد میگیرد؛ مثل متن، عکس یا صدا. کیفیت و تنوع داده آموزشی مستقیماً روی دقت و سوگیری مدل اثر میگذارد.
آموزش (Training)
فرایندی که در آن مدل بارها حدس میزند، حدسش با جواب درست مقایسه میشود و پارامترهایش کمی اصلاح میشود. آموزش مدلهای بزرگ هفتهها یا ماهها روی هزاران پردازنده طول میکشد.
پیشآموزش (Pre-training)
مرحله اول آموزش مدلهای بزرگ که در آن مدل حجم عظیمی از داده عمومی را میبیند و الگوهای کلی را یاد میگیرد؛ قبل از اینکه برای کار خاصی تنظیم شود.
پارامتر یا وزن (Parameter / Weight)
عددهای داخل مدل که در طول آموزش تنظیم میشوند و دانستههای مدل را نگه میدارند. مدلهای زبانی بزرگ میلیاردها پارامتر دارند؛ اما تعداد بیشتر همیشه به معنی مدل بهتر نیست.
یادگیری نظارتشده (Supervised Learning)
یادگیری از نمونههایی که جواب درستشان مشخص است؛ مثل هزاران عکس با برچسب «گربه» یا «سگ». مدل یاد میگیرد از ورودی به جواب درست برسد.
یادگیری بدون نظارت (Unsupervised Learning)
یادگیری از دادههای بدون برچسب، برای پیدا کردن الگو یا گروهبندی؛ مثلاً دستهبندی خودکار مشتریها بر اساس رفتار خرید.
یادگیری تقویتی (Reinforcement Learning)
روشی که در آن مدل با آزمون و خطا و دریافت «پاداش» یا «جریمه» یاد میگیرد چه کاری بهتر است. AlphaGo با همین روش در بازی گو قهرمان جهان را شکست داد.
یادگیری تقویتی از بازخورد انسانی (RLHF)
مرحلهای از آموزش چتباتها که در آن انسانها جوابهای مختلف مدل را رتبهبندی میکنند و مدل یاد میگیرد جوابهای مفیدتر، صادقانهتر و بیخطرتر بدهد.
تنظیم دقیق (Fine-tuning)
آموزش اضافه یک مدل ازپیشآموزشدیده روی دادههای تخصصیتر، تا در کار یا حوزه خاصی بهتر شود؛ مثلاً یک مدل عمومی که برای متون حقوقی تنظیم میشود.
بیشبرازش (Overfitting)
وقتی مدل نمونههای آموزشی را بهجای یادگیری الگوی کلی «حفظ» میکند؛ روی داده آموزشی عالی است اما روی داده تازه ضعیف عمل میکند. مثل دانشآموزی که جوابها را حفظ کرده ولی مفهوم را نفهمیده.
استنتاج (Inference)
مرحله استفاده از مدل آموزشدیده: ورودی جدید میگیرد و جواب میسازد. هر بار که با یک چتبات حرف میزنید، مدل در حال استنتاج است و از شما چیزی یاد نمیگیرد.
۳. مدلهای زبانی و چتباتها
مدل زبانی بزرگ (Large Language Model, LLM)
شبکه عصبی بسیار بزرگی که روی حجم عظیمی از متن آموزش دیده تا کلمه بعدی را پیشبینی کند. همین توانایی ساده، پایه نوشتن، خلاصهسازی، ترجمه و گفتوگوی چتباتهاست.
ترنسفورمر (Transformer)
معماری شبکه عصبی که در مقاله «Attention Is All You Need» در سال ۲۰۱۷ معرفی شد و پایه تقریباً همه مدلهای زبانی بزرگ امروزی است. حرف T در GPT هم از همین کلمه میآید.
سازوکار توجه (Attention)
بخشی از ترنسفورمر که به مدل اجازه میدهد هنگام پردازش هر کلمه، بفهمد کدام کلمههای دیگر متن برایش مهمترند؛ مثلاً اینکه ضمیر «آن» به کدام اسم برمیگردد.
توکن (Token)
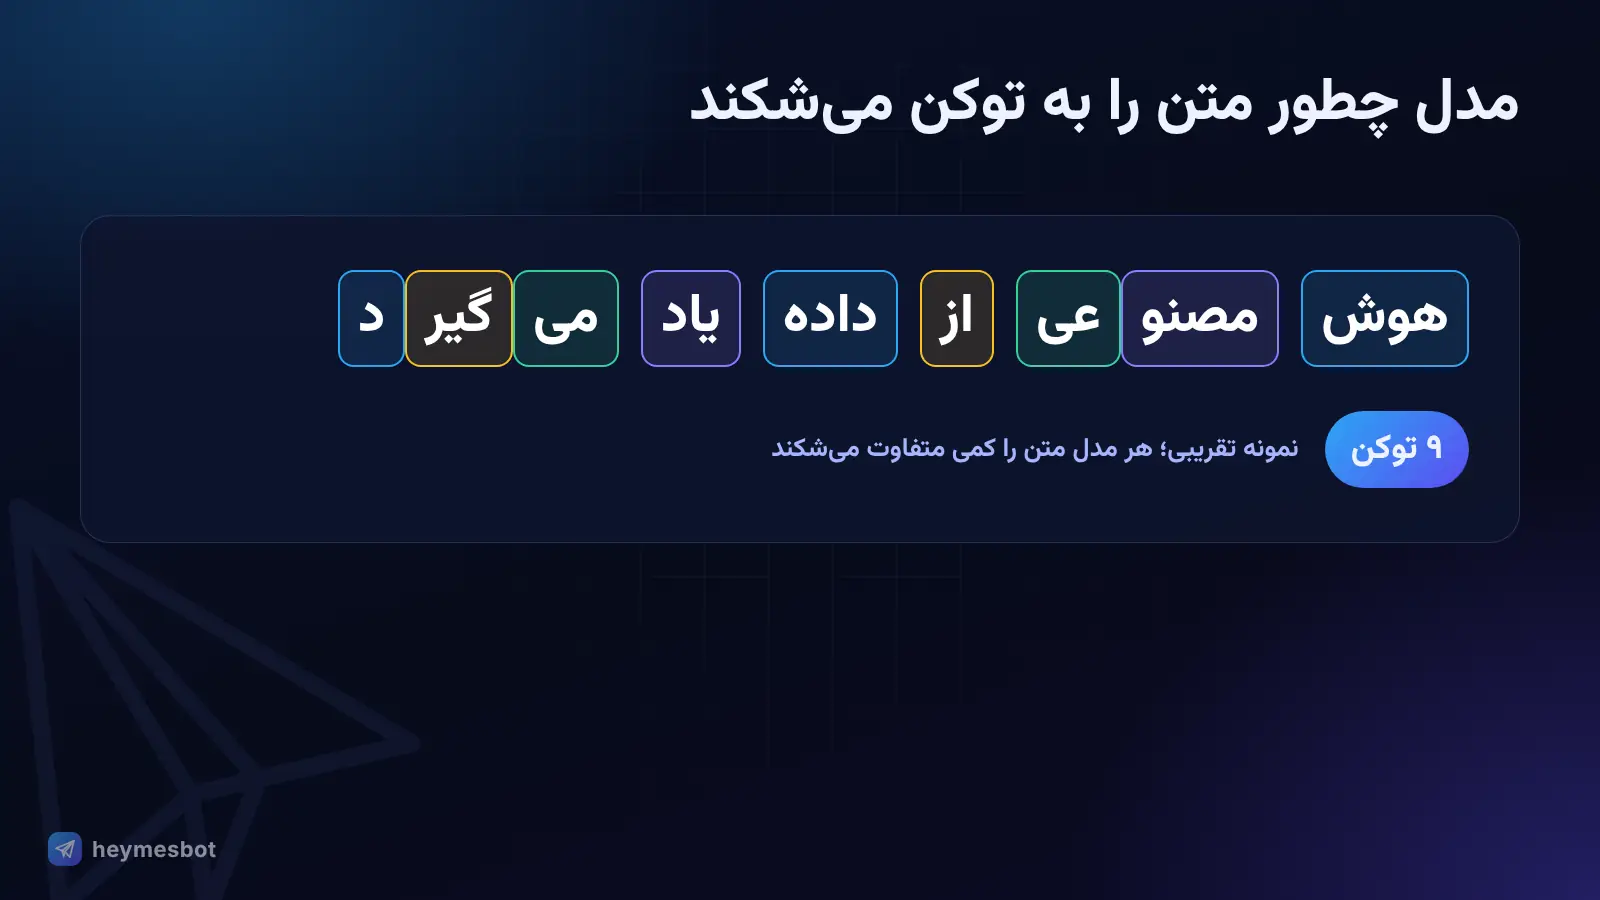
کوچکترین تکه متنی که مدل با آن کار میکند؛ یک کلمه، بخشی از کلمه یا یک علامت. در انگلیسی هر توکن حدود سهچهارم کلمه است و در فارسی معمولاً هر کلمه به چند توکن شکسته میشود. هزینه استفاده و محدودیت طول مدلها با توکن سنجیده میشود.
پنجره زمینه (Context Window)
حداکثر مقدار متنی (بر حسب توکن) که مدل در یک لحظه میتواند «ببیند»؛ شامل پیامهای قبلی گفتوگو و سند ضمیمه. اگر گفتوگو از این حد طولانیتر شود، بخشهای قدیمی از حافظه کاری مدل بیرون میروند.
امبدینگ (Embedding)
تبدیل کلمه، جمله یا تصویر به فهرستی از عددها، طوری که مفاهیم مشابه عددهای نزدیک به هم داشته باشند. جستجوی معنایی و RAG بر پایه امبدینگ کار میکنند.
دما (Temperature)
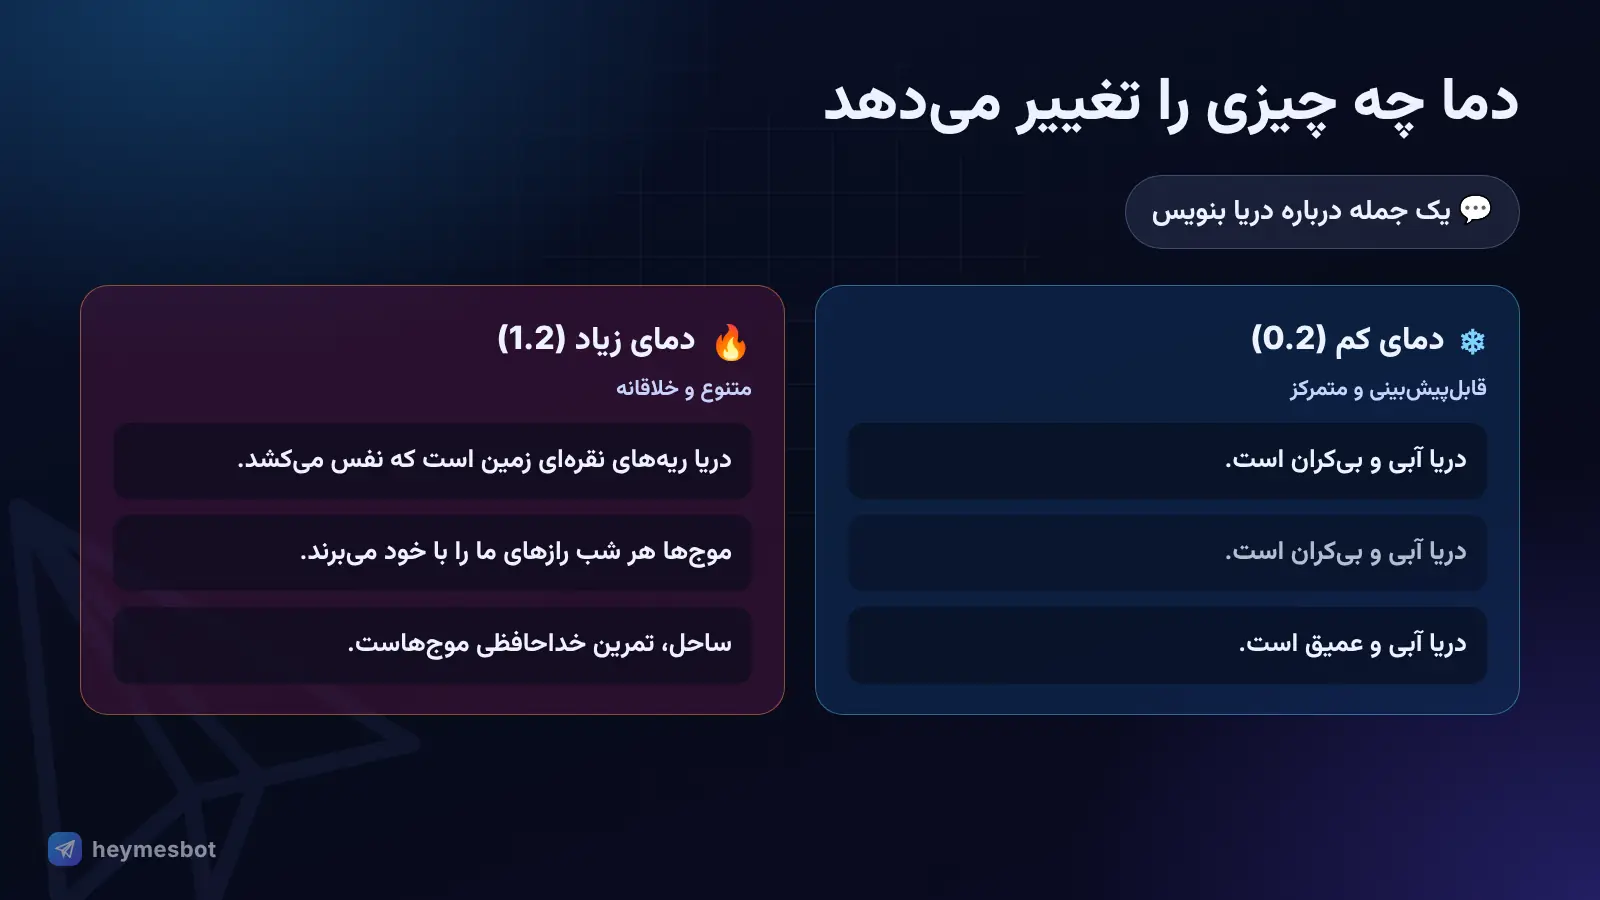
تنظیمی که میزان تصادفی بودن جواب مدل را کنترل میکند. دمای کم جوابهای قابلپیشبینیتر و دقیقتر میدهد و دمای زیاد جوابهای متنوعتر و خلاقانهتر.
توهم (Hallucination)
وقتی مدل جوابی روان و قانعکننده میدهد که نادرست یا ساختگی است؛ مثل آمار ناموجود یا منبع خیالی. دلیلش این است که مدل برای تولید متن محتمل آموزش دیده، نه بررسی حقیقت.
چتبات (Chatbot)
برنامهای که با کاربر به زبان طبیعی گفتوگو میکند. چتباتهای امروزی معمولاً روی مدلهای زبانی بزرگ ساخته شدهاند.
مدل استدلالی (Reasoning Model)
مدل زبانیای که قبل از جواب نهایی، مسئله را گامبهگام «فکر» میکند. این مدلها در ریاضی، برنامهنویسی و مسائل چندمرحلهای بهترند، اما معمولاً کندتر و پرهزینهترند.
۴. تصویر، ویدیو و صدا
مدل انتشار (Diffusion Model)
روش اصلی بیشتر عکسسازهای امروزی. مدل یاد گرفته نویز را گامبهگام از تصویر پاک کند؛ در زمان تولید، از نویز کاملاً تصادفی شروع میکند و با راهنمایی متن شما آن را به تصویر تبدیل میکند.
متن به تصویر (Text-to-Image)
ساختن تصویر از روی توصیف متنی؛ مثلاً «فانوس دریایی در غروب، به سبک آبرنگ».
ویرایش تصویر با هوش مصنوعی (Inpainting / Image Editing)
تغییر بخشی از یک تصویر موجود با دستور متنی؛ مثل حذف یک شیء، عوض کردن پسزمینه یا اضافه کردن جزئیات، بدون دست زدن به بقیه تصویر.
متن به ویدیو (Text-to-Video)
ساختن ویدیوی کوتاه از روی توصیف متنی یا یک تصویر. چون فریمها باید در طول زمان با هم هماهنگ بمانند، ساخت ویدیو بسیار پرهزینهتر از عکس است.
تبدیل متن به گفتار (Text-to-Speech, TTS)
تبدیل متن نوشتهشده به صدای طبیعی، با لحن و مکث مناسب. در کتاب صوتی، صداگذاری ویدیو و دستیارهای صوتی کاربرد دارد.
تشخیص گفتار (Speech-to-Text, ASR)
تبدیل صدای گفتار به متن نوشتهشده؛ مثل زیرنویس خودکار یا تایپ صوتی.
شبیهسازی صدا (Voice Cloning)
ساختن صدایی شبیه صدای یک فرد خاص با هوش مصنوعی. به دلیل خطر سوءاستفاده و حقوق صاحب صدا، بیشتر سرویسهای معتبر تقلید صدای افراد واقعی بدون اجازه را محدود میکنند.
دیپفیک (Deepfake)
عکس، صدا یا ویدیوی جعلی و واقعنما که با هوش مصنوعی ساخته شده تا کسی را در حال گفتن یا انجام کاری نشان دهد که هرگز انجام نداده. به محتوای تکاندهنده بدون منبع معتبر اعتماد نکنید.
چندوجهی (Multimodal)
مدلی که چند نوع داده را با هم میفهمد یا تولید میکند؛ مثلاً عکس را میبیند و دربارهاش حرف میزند، یا از متن، تصویر و صدا میسازد.
۵. استفاده از هوش مصنوعی
پرامپت (Prompt)
متن یا دستوری که به هوش مصنوعی میدهید: سؤال، درخواست یا توصیف تصویر. کیفیت پرامپت تأثیر مستقیمی بر کیفیت نتیجه دارد.
مهندسی پرامپت (Prompt Engineering)
مهارت نوشتن پرامپتهایی که بهترین نتیجه را بگیرند؛ مثل مشخص کردن نقش، هدف، مخاطب، قالب خروجی و ارائه نمونه.
پرامپت سیستمی (System Prompt)
دستورالعمل پنهانی که سازنده یک چتبات در ابتدای هر گفتوگو به مدل میدهد تا رفتار، لحن و محدودیتهایش را تعیین کند.
بدون نمونه و با چند نمونه (Zero-shot / Few-shot)
در «بدون نمونه» فقط درخواست را میگویید؛ در «با چند نمونه» چند مثال از ورودی و خروجی دلخواه هم میدهید تا مدل الگو را بگیرد. چند نمونه خوب معمولاً نتیجه را بهشدت بهتر میکند.
تولید افزوده با بازیابی (Retrieval-Augmented Generation, RAG)
روشی که در آن مدل قبل از جواب دادن، اطلاعات مرتبط را از منبعی بیرونی مثل اسناد شرکت یا جستجوی وب پیدا میکند و جوابش را بر اساس آن میسازد. این کار جوابها را بهروزتر میکند و توهم را کاهش میدهد.
عامل هوش مصنوعی (AI Agent)
سیستمی که فقط جواب نمیدهد، بلکه برای رسیدن به یک هدف چند قدم را خودش برنامهریزی و اجرا میکند: جستجو میکند، ابزار به کار میبرد، فایل میسازد و نتیجه را بررسی میکند.
API (رابط برنامهنویسی)
راهی که نرمافزارها از طریق آن مستقیماً به یک مدل هوش مصنوعی وصل میشوند و از آن استفاده میکنند. بسیاری از اپلیکیشنها و رباتها، مدلهای شرکتهای بزرگ را از طریق API به کار میبرند و معمولاً به ازای هر توکن هزینه میپردازند.
مدل متنباز یا وزنباز (Open-source / Open-weight Model)
مدلی که پارامترهایش بهصورت عمومی منتشر شده و هر کسی میتواند آن را دانلود، روی سرور خودش اجرا یا تنظیم دقیق کند. مدلهای بسته فقط از طریق سرویس یا API سازنده در دسترساند.
۶. ایمنی، اخلاق و قانون
سوگیری (Bias)
گرایش مدل به نتایج ناعادلانه یا یکطرفه، معمولاً به خاطر عدم توازن یا تعصب در داده آموزشی؛ مثلاً تصویرسازی یک شغل همیشه با یک جنسیت.
همراستاسازی (Alignment)
تلاش برای اینکه رفتار هوش مصنوعی با اهداف و ارزشهای انسانی هماهنگ باشد؛ یعنی مفید، صادق و بیخطر بماند و کاری را انجام دهد که واقعاً منظور ماست.
گاردریل یا فیلتر ایمنی (Guardrails)
قواعد و فیلترهایی که سازندگان مدلها برای جلوگیری از تولید محتوای خطرناک، غیرقانونی یا آسیبزا به کار میبرند. وقتی یک ابزار درخواستی را «به دلیل محدودیت محتوایی» رد میکند، معمولاً گاردریل سازنده مدل عمل کرده است.
جیلبریک (Jailbreak)
تلاش برای فریب دادن مدل با پرامپتهای خاص تا محدودیتهای ایمنیاش را نادیده بگیرد. سازندگان مدلها مدام این روشها را شناسایی و مسدود میکنند و استفاده از آنها معمولاً خلاف قوانین سرویس است.
واترمارک و برچسب محتوای هوش مصنوعی (AI Watermarking)
نشانههای قابلدیدن یا پنهانی که در محتوای ساختهشده با هوش مصنوعی قرار میگیرد تا منشأ آن قابل تشخیص باشد. قوانین جدید، از جمله قانون هوش مصنوعی اروپا، به سمت الزامی کردن آن رفتهاند.
قانون هوش مصنوعی اتحادیه اروپا (EU AI Act)
نخستین قانون جامع هوش مصنوعی در جهان که از ۱ اوت ۲۰۲۴ لازمالاجرا شد و تعهداتش مرحلهبهمرحله اعمال میشود. سیستمها را بر اساس میزان خطر دستهبندی میکند؛ بعضی کاربردها را ممنوع میکند و برای محتوای ساختهشده با هوش مصنوعی الزام شفافیت میگذارد.
حریم خصوصی داده (Data Privacy)
حفاظت از اطلاعات شخصی در هنگام استفاده از هوش مصنوعی. قاعده ساده: رمز عبور، شماره کارت، مدارک هویتی و اطلاعات محرمانه را در هیچ چتباتی وارد نکنید و سیاست نگهداری داده هر سرویس را بدانید.
از اصطلاح تا تجربه
دانستن اصطلاحات نیمی از راه است؛ نیم دیگر، امتحان کردن خود ابزارهاست. برای شروع، سراغ یک ابزار گفتوگو مثل ChatGPT، Gemini یا Claude بروید، یا اگر ترجیح میدهید گفتوگو، ساخت تصویر، ویدیو، صدا و موسیقی را یکجا داخل تلگرام داشته باشید، هِیمِس را امتحان کنید. با هر کدام، چند پرامپت ساده بنویسید و ببینید اصطلاحاتی مثل «توکن»، «دما» یا «توهم» در عمل چه شکلی دارند.
برای فهم عمیقتر سازوکار این مفاهیم، راهنمای کامل «هوش مصنوعی چیست و چطور کار میکند؟» را بخوانید.
دیدگاهها
هنوز دیدگاهی ثبت نشده. اولین نفری باشید که نظر میدهد.
دیدگاه خود را بنویسید
دیدگاهها پس از بررسی نمایش داده میشوند. لطفاً مرتبط و محترمانه بنویسید.