قاموس مصطلحات الذكاء الاصطناعي: 55 مصطلحًا مشروحًا ببساطة (2026)
كل مصطلح تسمعه في عالم الذكاء الاصطناعي، من الرموز والأوامر إلى النماذج اللغوية الكبيرة والهلوسة وRAG ووكلاء الذكاء الاصطناعي، مشروح ببساطة وبأمثلة في هذا القاموس، ضمن ستة محاور من الأساسيات حتى الأمان والقانون.
لمن هذا القاموس؟ لكل من يصادف في الأحاديث أو الأخبار أو أدوات الذكاء الاصطناعي كلمات مثل «الرمز» أو «البرومبت» أو «النموذج اللغوي الكبير» ويريد فهمها دون خلفية تقنية. لكل مصطلح مقابله الإنجليزي وتعريف بسيط ومثال عند الحاجة.
إن كنت جديدًا على الذكاء الاصطناعي فابدأ بدليل «ما هو الذكاء الاصطناعي وكيف يعمل؟» واحتفظ بهذه الصفحة مرجعًا.
كيف تستخدم هذا القاموس
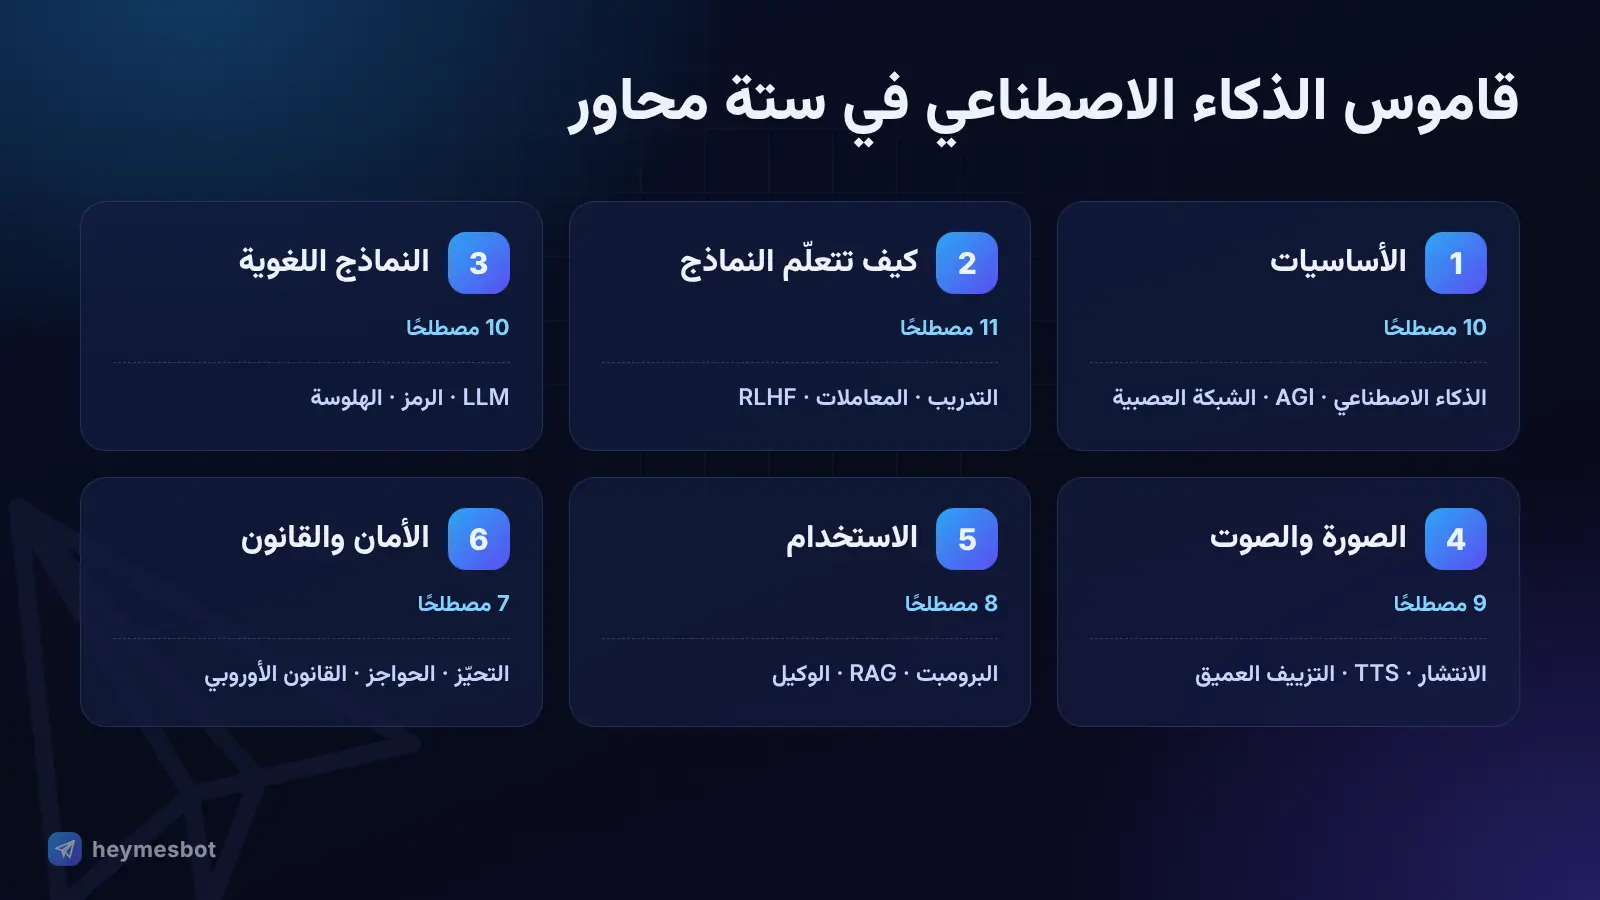
المصطلحات موزّعة على ستة محاور من الأساسيات حتى الأمان والقانون
بجانب كل مصطلح مقابله الإنجليزي لتتعرّف عليه في المصادر الأخرى
للعثور على مصطلح بسرعة استخدم البحث في المتصفح (Ctrl+F)
١. المفاهيم الأساسية
الذكاء الاصطناعي (Artificial Intelligence, AI)
برنامج يتعلّم الأنماط من البيانات بدلًا من اتباع قواعد مكتوبة مسبقًا، ويستخدمها في مهام مثل فهم اللغة أو التعرّف على الصور أو إنشاء المحتوى. وهو أيضًا اسم المجال كله.
الذكاء الاصطناعي الضيق (Narrow AI)
ذكاء اصطناعي يجيد مهمة أو بضع مهام محددة، مثل الترجمة أو التعرّف على الوجوه أو المحادثة. كل أدوات الذكاء الاصطناعي اليوم، حتى أكثر روبوتات المحادثة تقدّمًا، من هذا النوع.
الذكاء الاصطناعي العام (Artificial General Intelligence, AGI)
ذكاء اصطناعي افتراضي يستطيع تعلّم وأداء أي مهمة ذهنية بشرية تقريبًا في أي مجال. هو هدف بحثي لكثير من المختبرات، لكنه غير موجود بعد ولا اتفاق على موعد تحقّقه.
الذكاء الفائق (Artificial Superintelligence, ASI)
ذكاء اصطناعي افتراضي يتفوّق على أذكى البشر في كل المجالات تقريبًا. يُطرح غالبًا في النقاشات المستقبلية وقضايا الأمان.
الخوارزمية (Algorithm)
سلسلة خطوات دقيقة لحل مشكلة ما. في الذكاء الاصطناعي تحدّد الخوارزميات طريقة التعلّم، ونتيجة هذا التعلّم هي «النموذج».
النموذج (Model)
حصيلة تدريب نظام ذكاء اصطناعي: ملف يضم ملايين إلى مليارات الأرقام تُختزن فيها معارفه. وعندما يقال «صدر نموذج جديد» فالمقصود هذا الملف المدرَّب.
التعلم الآلي (Machine Learning, ML)
فرع من الذكاء الاصطناعي تتعلّم فيه الآلة من الأمثلة بدلًا من البرمجة الصريحة. فلاتر البريد المزعج واقتراحات منصات البث أمثلة يومية عليه.
التعلم العميق (Deep Learning)
نوع من التعلم الآلي يستخدم شبكات عصبية كثيرة الطبقات. أكبر قفزات العقد الأخير، من التعرّف على الكلام إلى روبوتات المحادثة، جاءت من التعلم العميق.
الشبكة العصبية (Neural Network)
بنية مستوحاة من الدماغ تتكوّن من طبقات من «الخلايا العصبية» الاصطناعية. تجمع كل خلية أرقامًا بأوزان مختلفة وتمرّر النتيجة إلى الطبقة التالية. ونالت جائزة نوبل في الفيزياء 2024 روّاد هذه الفكرة.
الذكاء الاصطناعي التوليدي (Generative AI)
نماذج تنشئ محتوى جديدًا: نصوصًا أو صورًا أو فيديو أو صوتًا أو شيفرة برمجية. ChatGPT ومولّدات الصور والموسيقى أمثلة عليه.
٢. كيف تتعلّم النماذج
بيانات التدريب (Training Data)
الأمثلة التي يتعلّم منها النموذج، مثل النصوص والصور والأصوات. جودة هذه البيانات وتنوّعها يؤثران مباشرة في دقة النموذج وتحيّزه.
التدريب (Training)
عملية يخمّن فيها النموذج مرارًا، ويُقارَن تخمينه بالإجابة الصحيحة، وتُعدَّل معاملاته قليلًا. يستغرق تدريب النماذج الكبيرة أسابيع أو أشهرًا على آلاف المعالجات.
التدريب المسبق (Pre-training)
المرحلة الأولى من تدريب النماذج الكبيرة، يطّلع فيها النموذج على كمّ هائل من البيانات العامة ويتعلّم الأنماط العامة قبل ضبطه لمهمة بعينها.
المعاملات أو الأوزان (Parameters / Weights)
الأرقام داخل النموذج التي تُضبط أثناء التدريب وتحفظ ما تعلّمه. للنماذج اللغوية الكبيرة مليارات المعاملات، لكن كثرتها لا تعني دائمًا نموذجًا أفضل.
التعلم الخاضع للإشراف (Supervised Learning)
التعلّم من أمثلة معروفة الإجابة الصحيحة، مثل آلاف الصور المصنّفة «قطة» أو «كلب». يتعلّم النموذج الوصول من المدخل إلى الإجابة الصحيحة.
التعلم غير الخاضع للإشراف (Unsupervised Learning)
التعلّم من بيانات غير مصنّفة لاكتشاف الأنماط أو المجموعات، مثل تقسيم العملاء تلقائيًا حسب سلوك الشراء.
التعلم المعزّز (Reinforcement Learning)
أسلوب يتعلّم فيه النموذج بالتجربة والخطأ، فيتلقى «مكافأة» أو «عقوبة» على أفعاله. وبهذا الأسلوب هزم AlphaGo بطل العالم في لعبة غو.
التعلم المعزّز من الملاحظات البشرية (RLHF)
مرحلة في تدريب روبوتات المحادثة يرتّب فيها أشخاص إجابات النموذج المختلفة، فيتعلّم تقديم إجابات أكثر فائدة وصدقًا وأمانًا.
الضبط الدقيق (Fine-tuning)
تدريب إضافي لنموذج مدرَّب مسبقًا على بيانات أكثر تخصّصًا ليتحسّن في مهمة أو مجال معيّن، مثل ضبط نموذج عام للنصوص القانونية.
الإفراط في التخصيص (Overfitting)
أن يحفظ النموذج أمثلة التدريب بدلًا من تعلّم النمط العام، فيتفوّق عليها ويضعف أمام البيانات الجديدة. كطالب حفظ الإجابات دون أن يفهم المادة.
الاستدلال (Inference)
مرحلة استخدام النموذج المدرَّب: يتلقى مدخلات جديدة وينتج إجابة. في كل مرة تتحدث فيها مع روبوت محادثة يكون النموذج في مرحلة الاستدلال ولا يتعلّم منك.
٣. النماذج اللغوية وروبوتات المحادثة
النموذج اللغوي الكبير (Large Language Model, LLM)
شبكة عصبية ضخمة جدًا دُرّبت على كميات هائلة من النصوص لتتنبأ بالكلمة التالية. هذه القدرة البسيطة هي أساس الكتابة والتلخيص والترجمة والمحادثة في روبوتات المحادثة.
المحوّل (Transformer)
بنية الشبكة العصبية التي قدّمتها ورقة Attention Is All You Need عام 2017، وهي أساس معظم النماذج اللغوية الكبيرة اليوم. وحرف «T» في GPT مأخوذ منها.
آلية الانتباه (Attention)
جزء من المحوّل يتيح للنموذج أن يدرك، عند معالجة كل كلمة، أي كلمات النص الأخرى أهم بالنسبة إليها، مثل الاسم الذي يعود إليه الضمير «هو».
الرمز أو التوكن (Token)
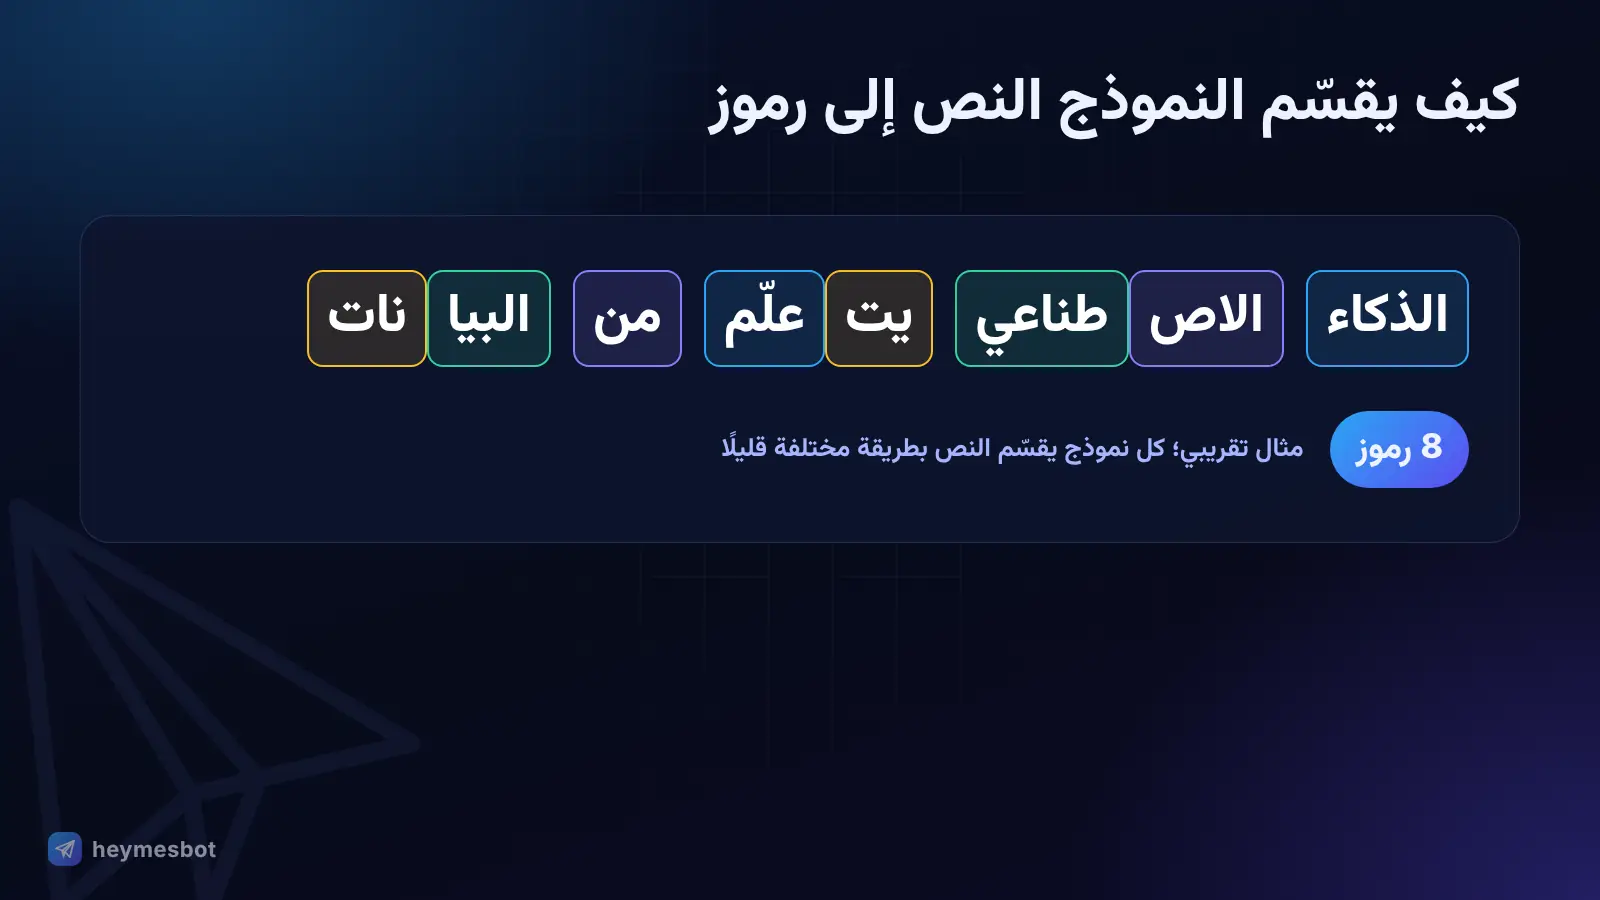
أصغر قطعة نصية يتعامل معها النموذج: كلمة أو جزء من كلمة أو علامة. في الإنجليزية يعادل الرمز نحو ثلاثة أرباع الكلمة، وفي العربية تنقسم الكلمة غالبًا إلى عدة رموز. وتُقاس تكلفة الاستخدام وحدود الطول بالرموز.
نافذة السياق (Context Window)
أقصى قدر من النص، مقيسًا بالرموز، يستطيع النموذج «رؤيته» في آن واحد، بما فيه الرسائل السابقة والمستندات المرفقة. وإذا طالت المحادثة أكثر من ذلك خرجت أقدم أجزائها من ذاكرة النموذج العاملة.
التضمين (Embedding)
تحويل كلمة أو جملة أو صورة إلى قائمة أرقام بحيث تحصل المعاني المتشابهة على أرقام متقاربة. ويقوم البحث الدلالي وRAG على التضمينات.
درجة الحرارة (Temperature)
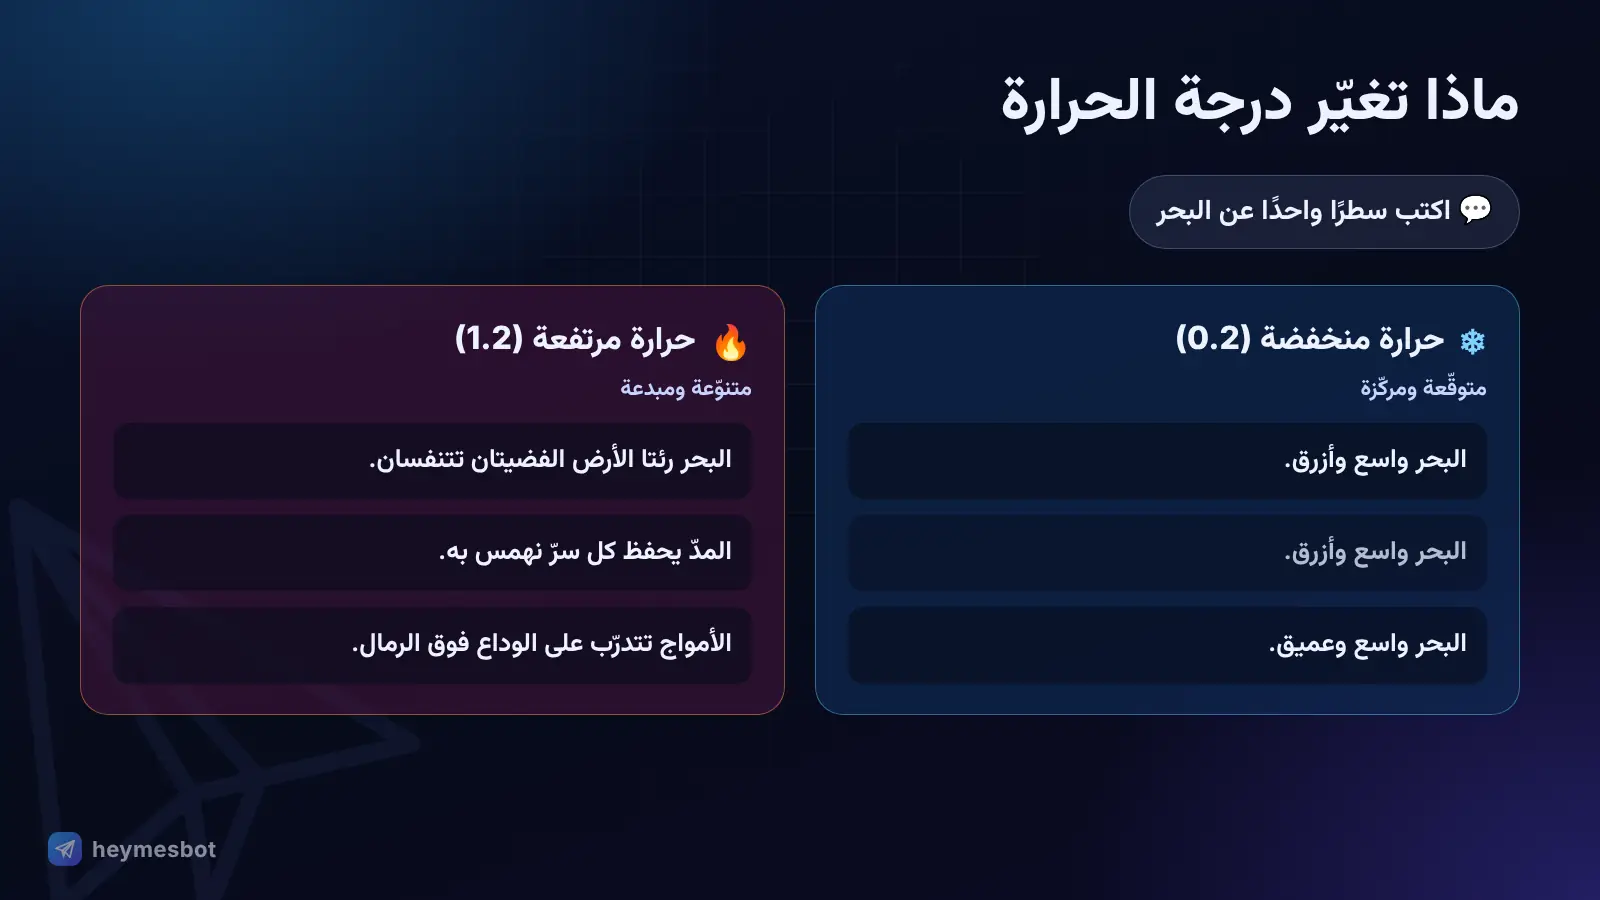
إعداد يتحكّم في مدى عشوائية إجابات النموذج. درجة الحرارة المنخفضة تعطي إجابات أكثر قابلية للتوقع وتركيزًا، والمرتفعة إجابات أكثر تنوعًا وإبداعًا.
الهلوسة (Hallucination)
أن يقدّم النموذج إجابة سلسة ومقنعة لكنها خاطئة أو مختلقة، مثل إحصائية غير موجودة أو مصدر مزيّف. وسببها أن النموذج مدرَّب على إنتاج نص معقول لا على التحقق من الحقائق.
روبوت المحادثة (Chatbot)
برنامج يحاور المستخدم باللغة الطبيعية. وتُبنى روبوتات المحادثة اليوم عادةً على نماذج لغوية كبيرة.
نموذج الاستدلال المنطقي (Reasoning Model)
نموذج لغوي يحلّل المسألة خطوة بخطوة قبل تقديم إجابته النهائية. هذه النماذج أفضل في الرياضيات والبرمجة والمسائل متعددة الخطوات، لكنها عادةً أبطأ وأعلى تكلفة.
٤. الصورة والفيديو والصوت
نموذج الانتشار (Diffusion Model)
التقنية الأساسية لمعظم مولّدات الصور اليوم. تعلّم النموذج إزالة الضوضاء من الصورة خطوة بخطوة، وعند التوليد يبدأ من ضوضاء عشوائية تمامًا ويحوّلها، مسترشدًا بنصّك، إلى صورة.
تحويل النص إلى صورة (Text-to-Image)
إنشاء صورة من وصف نصي، مثل «منارة عند الغروب بأسلوب الألوان المائية».
تحرير الصور بالذكاء الاصطناعي (Inpainting)
تغيير جزء من صورة موجودة بأمر نصي، مثل حذف عنصر أو استبدال الخلفية أو إضافة تفاصيل، دون المساس ببقية الصورة.
تحويل النص إلى فيديو (Text-to-Video)
إنشاء فيديو قصير من وصف نصي أو صورة. ولأن الإطارات يجب أن تبقى متناسقة عبر الزمن، يكلّف توليد الفيديو أكثر بكثير من الصورة.
تحويل النص إلى كلام (Text-to-Speech, TTS)
تحويل النص المكتوب إلى صوت طبيعي بنبرة ووقفات مناسبة. يُستخدم في الكتب الصوتية والتعليق على الفيديو والمساعدات الصوتية.
التعرّف على الكلام (Speech-to-Text, ASR)
تحويل الكلام المنطوق إلى نص مكتوب، مثل الترجمة النصية التلقائية أو الكتابة بالصوت.
استنساخ الصوت (Voice Cloning)
إنشاء صوت يشبه صوت شخص معيّن بالذكاء الاصطناعي. وبسبب خطر إساءة الاستخدام وحقوق صاحب الصوت، تقيّد معظم الخدمات الموثوقة تقليد أصوات الأشخاص الحقيقيين دون إذن.
التزييف العميق (Deepfake)
صورة أو صوت أو فيديو مزيّف لكنه واقعي، صُنع بالذكاء الاصطناعي ليُظهر شخصًا يقول أو يفعل ما لم يقله أو يفعله قط. لا تثق بمحتوى صادم دون مصدر موثوق.
متعدد الوسائط (Multimodal)
نموذج يفهم أو ينتج عدة أنواع من البيانات معًا، كأن ينظر إلى صورة ويتحدث عنها، أو يحوّل النص إلى صور وأصوات.
٥. استخدام الذكاء الاصطناعي
البرومبت أو الأمر (Prompt)
النص أو التعليمات التي تعطيها للذكاء الاصطناعي: سؤال أو طلب أو وصف صورة. وجودة البرومبت تؤثر مباشرة في جودة النتيجة.
هندسة الأوامر (Prompt Engineering)
مهارة كتابة أوامر تحقق أفضل النتائج، مثل تحديد الدور والهدف والجمهور وشكل المخرجات وتقديم أمثلة.
أمر النظام (System Prompt)
تعليمات خفية يعطيها صانع روبوت المحادثة للنموذج في بداية كل محادثة لتحديد سلوكه ونبرته وحدوده.
بلا أمثلة وببضعة أمثلة (Zero-shot / Few-shot)
في أسلوب «بلا أمثلة» تذكر طلبك فقط، وفي أسلوب «ببضعة أمثلة» تضيف أمثلة قليلة على المدخلات والمخرجات التي تريدها كي يلتقط النموذج النمط. وبضعة أمثلة جيدة تحسّن النتيجة كثيرًا في الغالب.
التوليد المعزّز بالاسترجاع (Retrieval-Augmented Generation, RAG)
أسلوب يبحث فيه النموذج أولًا عن المعلومات ذات الصلة في مصدر خارجي، مثل مستندات الشركة أو بحث الويب، ثم يبني إجابته عليها. وهذا يبقي الإجابات أحدث ويقلّل الهلوسة.
وكيل الذكاء الاصطناعي (AI Agent)
نظام لا يكتفي بالإجابة، بل يخطط وينفّذ بنفسه عدة خطوات لبلوغ هدف ما: يبحث ويستخدم الأدوات وينشئ الملفات ويتحقق من النتيجة.
واجهة برمجة التطبيقات (API)
الطريقة التي تتصل بها البرامج مباشرة بنموذج ذكاء اصطناعي وتستخدمه. تستخدم تطبيقات وبوتات كثيرة نماذج الشركات الكبرى عبر API، وتدفع عادةً مقابل كل رمز.
النموذج المفتوح (Open-source / Open-weight Model)
نموذج نُشرت معاملاته علنًا، فيستطيع أي شخص تنزيله وتشغيله على خادمه أو ضبطه. أما النماذج المغلقة فلا تتاح إلا عبر خدمة صانعها أو واجهته البرمجية.
٦. الأمان والأخلاقيات والقانون
التحيّز (Bias)
ميل النموذج إلى نتائج غير عادلة أو أحادية، غالبًا بسبب خلل أو تحيّز في بيانات التدريب، مثل تصوير مهنة معيّنة دائمًا بجنس واحد.
المواءمة (Alignment)
الجهود الرامية إلى جعل سلوك الذكاء الاصطناعي منسجمًا مع أهداف البشر وقيمهم، ليبقى مفيدًا وصادقًا وآمنًا ويفعل ما نقصده فعلًا.
الحواجز أو فلاتر الأمان (Guardrails)
قواعد وفلاتر يستخدمها صانعو النماذج لمنع إنتاج محتوى خطير أو غير قانوني أو مؤذٍ. وعندما ترفض أداة طلبًا «بسبب قيود المحتوى» فغالبًا ما تكون حواجز صانع النموذج هي التي عملت.
كسر الحماية (Jailbreak)
محاولة خداع النموذج بأوامر خاصة ليتجاهل قيود الأمان. يكتشف صانعو النماذج هذه الأساليب ويحظرونها باستمرار، واستخدامها يخالف عادةً شروط الخدمة.
العلامة المائية ووسم محتوى الذكاء الاصطناعي (AI Watermarking)
علامات ظاهرة أو خفية توضع في المحتوى المصنوع بالذكاء الاصطناعي ليُعرف مصدره. وتتجه القواعد الجديدة، ومنها قانون الذكاء الاصطناعي الأوروبي، إلى جعلها إلزامية.
قانون الذكاء الاصطناعي للاتحاد الأوروبي (EU AI Act)
أول قانون شامل للذكاء الاصطناعي في العالم. دخل حيز التنفيذ في 1 أغسطس 2024، وتُطبَّق التزاماته على مراحل على مدى عدة سنوات. يصنّف الأنظمة حسب درجة الخطر، ويحظر بعض الاستخدامات، ويفرض قواعد شفافية على المحتوى المصنوع بالذكاء الاصطناعي.
خصوصية البيانات (Data Privacy)
حماية المعلومات الشخصية عند استخدام الذكاء الاصطناعي. القاعدة البسيطة: لا تُدخل كلمات المرور أو أرقام البطاقات أو وثائق الهوية أو المعلومات السرية في أي روبوت محادثة، واعرف سياسة الاحتفاظ بالبيانات لدى كل خدمة.
من المصطلح إلى التجربة
معرفة المصطلحات نصف الطريق، والنصف الآخر تجربة الأدوات نفسها. ابدأ بأداة محادثة مثل ChatGPT أو Gemini أو Claude، وإن كنت تفضّل جمع المحادثة وإنشاء الصور والفيديو والصوت والموسيقى في مكان واحد داخل تيليجرام فجرّب heymesbot. اكتب بضعة أوامر بسيطة وشاهد كيف تبدو «الرموز» و«درجة الحرارة» و«الهلوسة» على أرض الواقع.
ولفهم أعمق لكيفية ترابط هذه المفاهيم، اقرأ الدليل الكامل «ما هو الذكاء الاصطناعي وكيف يعمل؟»
التعليقات
لا توجد تعليقات بعد. كن أول من يعلّق.
اكتب تعليقًا
تظهر التعليقات بعد المراجعة. يُرجى أن يكون التعليق ذا صلة ومهذبًا.